Headscale: Self-Hosted-Alternative zu Tailscale mit Installation und Anwendungsfällen
Umfassender Überblick über Headscale – die Self-Hosted-Alternative zu Tailscale. Wir erläutern die Architektur, Installation via Docker und systemd, die Einrichtung von OIDC und ACL, DERP und Routen, geben 7 praxisnahe Szenarien mit messbaren Ergebnissen, Tipps und einen Vergleich mit Alternativen.
Inhalt des Artikels
- Einleitung: warum ein self-hosted headscale sinnvoll ist und welche probleme es löst
- Headscale service-überblick: hauptfunktionen, architektur und vorteile
- Szenario 1: homelab ohne offene ports – privater zugriff auf nas, kameras und dienste
- Szenario 2: teamzugriff auf staging und ci/cd-artefakte zwischen clouds
- Szenario 3: anschluss eines geschlossenen industriellen netzwerks (ot) via subnet router mit zugangskontrolle
- Szenario 4: hybrid – on-prem-datenbank mit cloud-kubernetes verbinden ohne öffentliches internet
- Szenario 5: exit-node für entfernte mitarbeiter mit policies und sicherem internetzugang
- Szenario 6: verwaltung von iot- und kameraparks an entfernten standorten
- Szenario 7: temporärer zugang für auftragnehmer und auditoren: ephemeral, tags, approval
- Installation und grundkonfiguration von headscale: von null zum ersten knoten
- Performance und stabilität: was erwartet wird und wie man misst
- Integration und automatisierung: wie man headscale ins bestehende ökosystem einbindet
- Vergleich mit alternativen: wo headscale seine stärken ausspielt und worauf zu achten ist
- Faq: häufige praktische fragen
- Fazit: für wen headscale ideal ist und wie der einstieg gelingt
Einleitung: Warum ein Self-Hosted Headscale sinnvoll ist und welche Probleme es löst
Wir leben in einer Welt mit verteilten Teams, hybrider Infrastruktur und vielen Umgebungen – vom Heimserver bis zu Cloud-Clustern in verschiedenen Regionen. Klassische VPNs decken hier längst nicht alle Anforderungen ab. Es braucht ein privates, selbstkonfigurierendes Netzwerk über das Internet, das einfach zu verbinden, ausfallsicher und skalierbar ist. Genau das bieten Mesh-Lösungen auf Basis von WireGuard, und Tailscale gehört zu den benutzerfreundlichsten davon. Doch Tailscale ist ein SaaS-Control-Plane. Wer aus Sicherheits-, Compliance- oder Kostengründen die Kontrolle behalten möchte, braucht eine Self-Hosted-Lösung. Hier kommt Headscale ins Spiel – eine freie Implementierung des Control-Planes, kompatibel mit Tailscale-Clients.
Headscale löst drei zentrale Herausforderungen: Du speicherst Metadaten und Zugangsschlüssel selbst; kannst Funktionen konfigurieren, die bei SaaS eingeschränkt sind; und hast planbare Kosten ohne Abhängigkeit von externen Anbietern. Dazu bekommst du ein privates Netzwerk auf WireGuard-Basis mit Ende-zu-Ende-Verschlüsselung, automatischer NAT-Weiterleitung und einfachem Onboarding von Geräten.
Headscale Service-Überblick: Hauptfunktionen, Architektur und Vorteile
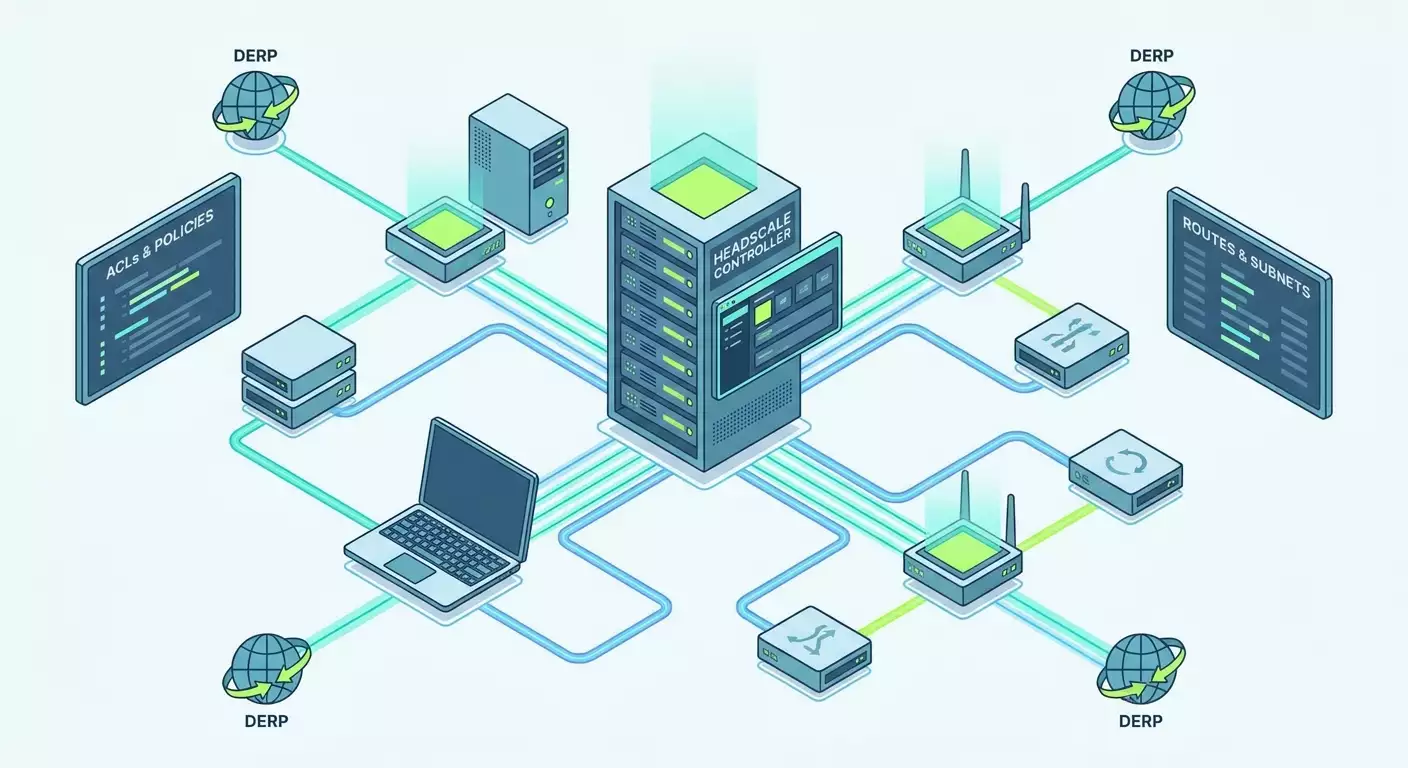
Was ist Headscale? Es ist ein Self-Hosted Control-Plane, das mit den Steuerprotokollen der Tailscale-Clients kompatibel ist. Die Daten übertragen sich über WireGuard, Schlüssel werden auf den Geräten erstellt, Steuerinformationen laufen über deinen Headscale. Du verwaltest Nutzer, ACL-Richtlinien, Routen, MagicDNS und optional eigene DERP-Relays. Headscale ist in Go geschrieben, die typische Installation besteht aus einem einzigen Binary oder Container plus Datenbank.
Architektur – Drei Ebenen: 1) tailscaled-Clients auf den Knoten (Linux, Windows, macOS, FreeBSD, Container und VMs), 2) dein Headscale (Control-Plane) mit Speicher (SQLite oder relationale DB), 3) DERP-Server für Traffic-Relay bei komplexen NAT-Szenarien. Standardmäßig verbinden sich Clients mit direkten WireGuard-Peers, wenn das nicht möglich ist, wird DERP genutzt. Der Control-Plane transportiert keinen Nutzverkehr, sondern gibt Adressen und Peerschlüssel aus.
Funktionalität (aktuell für Produktionsrollouts 2026):
- Kompatibel mit aktuellen Tailscale-Clients für Desktop- und Serverplattformen.
- Benutzer und Gruppen, Tagging für Service-Knoten, vorkonfigurierte Preauth-Schlüssel, kurzlebige (ephemere) Schlüssel für externe Dienstleister.
- ACL-Richtlinien mit expliziter Erlaubnis-Logik, Regeln basierend auf Benutzern, Gruppen, Tags, Ports und Protokollen. Unterstützung von Tag-Policies für Headless Nodes.
- Subnet-Router, Ankündigung externer Netzwerke, Exit Nodes für den gesamten Internetverkehr über vertrauenswürdige Knoten.
- MagicDNS für stabile Namen von Knoten und Diensten im privaten Netzwerk.
- OIDC-Authentifizierung mit Unternehmens-SSO, Benutzer-Claims und automatischer Kontoanlage.
- DERP-Integration: Öffentliche Relay-Dienste nutzbar oder eigene Relays zur Latenz- und Abhängigkeitsreduzierung aufsetzen.
- Prometheus-Metriken und Logging für Audits und Monitoring.
Vorteile: Das Wichtigste – Kontrolle und Isolation. Du verwaltest den Lebenszyklus von Schlüsseln und Policies, behältst Metadaten bei dir, und die Kosten wachsen nicht linear mit der Knotenzahl (besonders bei Hunderten und Tausenden). WireGuard-Leistung ist hoch: Auf modernen x86-64-Systemen sind leicht hunderte Mbit/s möglich, die Latenz oft auf Internetroutenniveau. Headscale passt gut zu DevOps-Tools und Infrastructure as Code (IaC), beschleunigt Onboarding von Standorten und Cloud-Migrationen ohne Brüche.
Szenario 1: Homelab ohne offene Ports – privater Zugriff auf NAS, Kameras und Dienste
Für wen und wofür
Für Ingenieure, DevOps-Experten und Enthusiasten mit Heimcluster: NAS, Mini-PCs mit Containern, Mediaserver, Smart Home. Ziel: Zugriff von der Arbeit und unterwegs ohne Port-Forwarding und öffentliche IP, mit Verschlüsselung und praktischen Hostnamen.
Funktionsweise
Du betreibst Headscale auf einem VPS oder Heimserver, registrierst Geräte per Preauth-Key. Auf jedem Knoten läuft tailscaled, der WireGuard-Tunnel zu Peers über private Adressen aufbaut. MagicDNS sorgt für konstante Namen, ACL verhindert unerwünschte Verbindungen.
Schritt-für-Schritt-Anleitung
- Bereite einen Server mit öffentlichem TCP/UDP-Zugang und NTP-synchronisierter Systemzeit vor. Installiere Headscale als Container oder Paket. Als Speicher kannst du mit SQLite starten und später auf relationale DB umsteigen.
- Aktiviere TLS-Termination via Reverse-Proxy. Einfach zu Hause ist das automatische Zertifikat. Proxye zu Headscale lokal und portmäßig.
- Erstelle den ersten Headscale-Benutzer (Administrator deines „Domains“). Generiere wiederverwendbare oder Einmal-Preauth-Keys für Geräte.
- Installiere Tailscale-Client auf den Knoten. Starte tailscaled und verbinde über Login-Server-Adresse und Preauth-Key. Für Headless-Server Tags wie tag:home-lab verwenden.
- Aktiviere MagicDNS und teste die Namensauflösung. Erstelle einfache ACLs: Zugriff vom Laptop aufs NAS und Mediaserver erlaubt, nicht umgekehrt.
- Optional: Wenn Geräte hinter symmetrischem NAT keine direkten Peerverbindungen aufbauen, richte lokalen DERP-Relay in der Nähe des Zuhauses ein.
Beispiel und Ergebnisse
Use Case: Mini-PC basierend auf N100 mit Docker, NAS und Home Assistant. Früher war externer Zugriff nur per Portforwarding und DDNS möglich. Nach Headscale: Zugang zu Mediaserver und Git-Runner von mobilem Laptop ohne offene Ports. Typische Latenz zwischen mobilem Laptop und Heimknoten sank von 65-80 ms auf 40-55 ms dank direktem WireGuard. Die Dateikopiergeschwindigkeit per SMB stieg über das private Netz von 12-20 auf 80-140 Mbit/s, abhängig vom Mobilnetz und Router.
Tipps und Praxis
- Vergib feste Host- und Service-Namen via MagicDNS, nutze kurze Aliase.
- Aktiviere Logging in Headscale und exportiere Metriken nach Prometheus für Transparenz.
- Begrenze bei energieeffizienten SoCs die MTU am WireGuard-Interface zur Fragmentierungsminimierung.
- Wenn ein Knoten oft Relay ist, gib ihm einen dedizierten Channel oder richte lokalen DERP ein, um Belastung zu reduzieren.
Szenario 2: Teamzugriff auf Staging und CI/CD-Artefakte zwischen Clouds
Für wen und wofür
Produkt- und Plattform-Teams, bei denen Staging über mehrere Anbieter und Regionen verteilt ist, und Git-Runner Container in einer Cloud bauen und Images in eine andere pushen. Ziel: Entwickler von SSH-Schlüsseln entlasten, Servicezugänge vereinfachen, Infrastruktur vor externem Internet abschirmen.
Funktionsweise
Setze Headscale in einem separaten Subnetz auf, registriere Build-Cluster, Staging und Entwickler-Laptops. Interner Traffic läuft über private Adressen, ACL regelt. Tags nutzt man auf Runnern und Servicenodes, statt individuell Nutzer-Schlüssel zu vergeben. Container Registry Secrets bleiben intern.
Schritt-für-Schritt-Anleitung
- Deploye Headscale, richte OIDC mit deinem Unternehmens-SSO-Provider ein. Damit kannst du Nutzer automatisch anlegen und Zugänge bei Ausscheiden entfernen.
- Erstelle Gruppen für Teams (z.B. devs, qa) und Tags für Services (tag:runner, tag:staging). Aktivere Default-deny Policy.
- Registriere Git-Runner und Staging-VMs mit Tags. Nutzer erhalten vorkonfigurierte Schlüssel oder melden sich per SSO an.
- Formuliere ACL: Entwickler -> Staging auf den benötigten Ports, Runner -> Registry, Cache-Artefakte -> Runner und Staging, kein öffentlicher Internetzugriff.
- Füge Subnet Router im Netzwerk mit alten Bare-Metal-Services hinzu, damit Staging auf sie zugreifen kann ohne Perimeter-Öffnung.
Beispiel und Ergebnisse
Firma mit 45 Entwicklern und 12 Runnern in zwei Regionen. Vorher SSH-Bastionen mit offenen Security Groups und häufiger „vergessener“ Schlüssel. Nach Headscale: Onboarding eines Entwicklers in 10 Minuten (SSO + Policy), Zugriffszeiten auf Staging von Stunden auf Minuten reduziert. Offene Perimeter-Ports von 38 auf 6 gesenkt. Egress-Traffic zwischen Regionen um 28 % reduziert durch direkte Peer-Tunnel.
Tipps und Praxis
- Nutze ephemeral-Keys für temporäre Auftragnehmer, Lebensdauer 8–24 Stunden, Verlängerung per Ticketanfrage.
- Headless Nodes nur mit Tags versehen – erleichtert Rotation und Audit, ohne Nutzerbindung.
- Bewahre CI-Adressen für Artefakt-Server und Registry als MagicDNS-Namen auf – das übersteht IP-Migrationen.
Szenario 3: Anschluss eines geschlossenen industriellen Netzwerks (OT) via Subnet Router mit Zugangskontrolle
Für wen und wofür
Integratoren und Automatisierungsingenieure mit PLCs, HMIs und Netzgeräten ohne moderne Remote-Lösungen. Ziel: Ingenieuren begrenzten Zugang für Diagnose und Updates geben, Netzwerk aber vom Internet isolieren.
Funktionsweise
Auf einem OT-Gateway läuft tailscaled mit aktivierter Subnet-Route. Ingenieure verbinden sich mit Headscale, erhalten nur Zugriff auf notwendige Ports (z.B. Modbus/TCP, HTTPS-Admin), Rest ist via ACL blockiert. Zugriff kann einseitig ohne Verbindungsanfragen zu Ingenieur-Laptops geregelt werden.
Schritt-für-Schritt-Anleitung
- Richte Gateway-Knoten am OT-Rand ein, ideal mit zwei Netzwerkschnittstellen: eine ins OT-Netz, eine ins IT/Internet.
- Installiere Tailscale-Client, registriere Knoten bei Headscale mit tag:ot-gateway. Aktiviere Route zum OT-Subnetz (z.B. 10.10.0.0/16).
- Aktiviere Route in Headscale. Konfiguriere ACL „Ingenieure -> tag:ot-gateway -> 10.10.0.0/16 tcp:443,502“ (Portbeispiel). Blockiere den Gegenzug.
- Aktiviere Access-Logging und Audit via SIEM, sammle Metriken.
Beispiel und Ergebnisse
Monitoring-Projekt auf entlegenem Feld: 3 Gateways, 17 PLCs und 4 HMIs. Früher L2VPN über teure Verbindungen. Nach Headscale mit Subnet Router sank Kanalpreis um 42 %, MTTR von 2 Stunden auf 25 Minuten dank stabilem Remote-Engineering. Paketinspection auf Gateway, End-to-End-Tunnel verschlüsselt.
Tipps und Praxis
- Beschränke Portlisten strikt, schließe RDP/SSH im OT aus, gib nur nötige Zugriffe.
- Führe Aktionsprotokolle und speichere sie mindestens 90 Tage.
- Für sensible Standorte eigenen lokalen DERP betreiben, um Traffic lande- und regionsintern zu halten.
Szenario 4: Hybrid – On-Prem-Datenbank mit Cloud-Kubernetes verbinden ohne öffentliches Internet
Für wen und wofür
Teams, die Services teilweise in Kubernetes auslagern, aber Datenbanken und Message Queues On-Prem halten. Ziel: einfachere Netzwerkverbindung ohne IPsec und komplexe Routing-Setups, schnelle Rollbacks und Cloud-Migrationen.
Funktionsweise
Auf jedem Cluster-Knoten (oder Gateway-Pod) läuft tailscaled. Datenbank wird per Subnet Router angekündigt oder als Knoten direkt im DB-Netzwerk betrieben. Anwendungen in Kubernetes nutzen MagicDNS-Namen der DB. ACL limitiert Zugang vom Namespace zu den nötigen Ports (5432, 27017 usw.).
Schritt-für-Schritt-Anleitung
- Erstelle Sidecar-Image oder DaemonSet mit tailscaled für Knoten/Pods, die privaten Ausgang brauchen. Alternativ nutze node-level tailscaled auf Worker Nodes.
- Registriere diese Knoten in Headscale mit tag:k8s. Für DB einen Knoten mit tag:db.
- Setze ACL: tag:k8s -> tag:db tcp:5432 plus alle nötigen Ports, verbiete für alle anderen Knoten Zugriff.
- Definiere MagicDNS-Namen für DB und verwende ihn in Manifest-Umgebungsvariablen.
- Für hohe Verfügbarkeit zwei DERP-Relays in verschiedenen Regionen aktivieren und Failover testen.
Beispiel und Ergebnisse
Fintech-Startup mit Kubernetes in zwei Regionen, On-Prem-DB mit erweitertem Support. Früher komplexes IPsec zwischen Routern mit gelegentlichen Ausfällen bei Schlüsselrotation. Nach Headscale: Bereitstellung neuer Umgebung in 15 Minuten, Ausfall von Region beeinträchtigt Verbindung nicht. Durchschnittliche DB-Latenz über Tunnel: Lesen 6-8 ms, Schreiben 8-12 ms, SLA über 99,95 % ohne manuellen Aufwand.
Tipps und Praxis
- Plane MTU sorgfältig: Kubernetes CNI + WireGuard verursachen Overhead; teste optimale Werte.
- Setze tailscaled in eine dedizierte Low-Priority-Cgroup, damit es nicht mit Workloads konkurriert.
- Für regionsübergreifende Anfragen Read-Replicas nutzen, damit latenzkritische Operationen lokal bleiben.
Szenario 5: Exit-Node für entfernte Mitarbeiter mit Policies und sicherem Internetzugang
Für wen und wofür
Unternehmen mit reisenden Mitarbeitern, die aus unsicheren Netzen arbeiten. Ziel: Internetzugang über Corporate-Node mit Filterung und Monitoring, ohne interne Dienste öffentlich freizugeben.
Funktionsweise
Dedicated Server als Exit Node aufsetzen, Forwarding und NAT aktivieren, ACL regelt, wer Exit nutzen darf. Logs und Content-Filter laufen auf Unternehmensseite.
Schritt-für-Schritt-Anleitung
- Server mit gutem Kanal und ausreichend CPU einrichten. IPv4/IPv6 Forwarding und NAT auf Firewall aktivieren.
- Node in Headscale mit tag:exit registrieren, Exit-Mode am Client aktivieren.
- In ACL der Gruppe "travelers" Exit-Berechtigung geben, anderen verweigern.
- DNS- und Web-Filter auf Exit-Server installieren, Metriken anbinden.
Beispiel und Ergebnisse
Outsourcing-Team mit 20 Leuten, viele Reisen. Früher offenes WLAN mit Risiko von Datenabgriffen. Nach Exit Node: kompletter Traffic wird über Corporate-Node geleitet, Einheitliche Sicherheitsrichtlinien und Logfiles möglich. Zusätzliche Latenz durchschnittlich 15-25 ms gegenüber direktem Zugang in regionalen Netzen.
Tipps und Praxis
- Plane zwei Exit Nodes in „ferner“ und „naher“ Region, wähle nahe geografisch für geringere Latenz.
- Aktiviere durchgängiges DNS via MagicDNS, zentralisiere Malware-Domain-Blocklisten.
- Vermeide, denselben Node als Exit und kritischen Business-Service zu nutzen – trenne Rollen für Vorhersagbarkeit.
Szenario 6: Verwaltung von IoT- und Kameraparks an entfernten Standorten
Für wen und wofür
Systemintegratoren und Firmen mit vielen Edge-Geräten, von Kameras bis Sensoren und Gateways. Ziel: Gerätezugriff für Diagnose und Updates ohne Port-Forwarding und SIM-APN-Tricks, mit klarer Nachverfolgung und Auditierung.
Funktionsweise
Auf jedem Standorts-Gateway läuft ein günstiger tailscaled. Er kündigt Subnetze mit Geräten an oder agiert als Proxy. Zentralserver und Ingenieure verbinden über Headscale. ACL regelt Verbindungen: Ingenieur -> Gateway -> Geräte. Kurzlebige Schlüssel für Wartungsfenster sind möglich.
Schritt-für-Schritt-Anleitung
- Standardisiere Gateway-Image mit tailscaled + Systemagenten, Basisschutz und Monitoring. Schließe SSH von außen.
- Setze Headscale auf, erstelle Tags tag:edge-gw und Ingenieur-Gruppen.
- Füge Routen zu lokalen Subnetzen der Geräte hinzu, aktiviere in Headscale-Konsole.
- Definiere ACL: Ingenieure -> tag:edge-gw -> Geräte mit erforderlichen Steuer- und Streaming-Ports.
- Implementiere Metriken- und Zugriffslogs samt Benachrichtigungen bei neuen Knoten.
Beispiel und Ergebnisse
Einzelhändler mit 120 Filialen und je 8-12 Kameras. Früher instabile Tunnels über Consumer-Router, schwer wartbar. Nach Headscale: stabile Verbindung 98,7 % der Zeit, Latenz zum HQ 18-32 ms, neue Filiale mit vorinstalliertem Gateway in 30 Minuten einsatzbereit. „Ungewöhnliche“ ausgehende Verbindungen verschwanden, da Zugriff nun über private Adressen initiiert wird.
Tipps und Praxis
- Aktiviere Watchdog und automatischen Neustart von tailscaled bei Netzfehlern am Gateway.
- Generiere Preauth-Keys in Chargen für Logistik; 48-72 Stunden Lebensdauer ist praktisch für Deployment.
- Bei hohem Videostrom setze lokale DERP in Schlüsselregionen, damit Tunnel keine weiten Relay-Knoten sucht.
Szenario 7: Temporärer Zugang für Auftragnehmer und Auditoren: Ephemeral, Tags, Approval
Für wen und wofür
Teams mit häufig wechselnden externen Spezialisten für begrenzte Zeit. Ziel: genau den nötigen Zugang gewähren und ihn automatisch am Ende der Aufgabe widerrufen, ohne manuellen Schlüssel-Reset.
Funktionsweise
Du erstellst ephemeral Preauth-Keys oder setzt Ablauf für normale Keys, vergibst Tags und ACL nur für Zielservices. Nach Ablauf taucht der Knoten spurlos aus dem Netz. Bei Bedarf kannst du vor Routenaktivierung eine Freigabe (Approval) verlangen.
Schritt-für-Schritt-Anleitung
- Lege Gruppe contractors und Tags tag:readonly, tag:reveng an.
- Erzeuge Preauth-Key mit 24-72 Stunden Ablauf, ohne Wiederverwendung.
- Definiere ACL nur für erforderliche Dienste, z.B. Webinterface der Testumgebung und Artefakt-Repository.
- Überwache Knoten in Logs, bei Bedarf manuelle Freigabe aktivieren.
Beispiel und Ergebnisse
Sicherheitsaudit über 10 Tage. Auftragnehmer bekam Zugang zu Staging-Umgebung und Log-Kopien. Nach Ablauf wurden Knoten automatisch entfernt. Beim nächsten Audit waren 15 Minuten für Wiederzugang nötig. Keine Vorfälle mit „vergessenen“ Schlüsseln.
Tipps und Praxis
- Markiere solche Knoten gut mit Tags und Namenpräfix, damit sie leicht auffindbar sind.
- Erteile Auftragnehmern keine Exit Node Berechtigung, außer es ist nötig.
- Benachrichtigungen bei Schlüsselablauf einstellen, um unerwarteten Verbindungsabbruch zu vermeiden.
Installation und Grundkonfiguration von Headscale: Von Null zum ersten Knoten
Umgebung vorbereiten
- Linux-Server mit öffentlichem TCP/UDP-Zugang. Uhrzeit per NTP synchronisiert.
- Dedizierter Domain-Name für Komfort. TLS-Termination via Reverse-Proxy.
- Offene ausgehende Verbindungen für Clients (UDP für NAT-Traversal).
Deployment
- Installiere Headscale als Container. Erstelle Compose-Datei mit headscale und ggf. DB. Mappe Headscale-Port lokal, TLS übernimmt Reverse-Proxy. Setze Umgebungsvariablen für Domain-Name, MagicDNS-Mode, SSO-Provider (optional).
- Starte Headscale, prüfe Logs und Service-Verfügbarkeit. Falls aktiviert, teste Prometheus-Metriken.
- Lege ersten Nutzer an (z.B. admin). Erzeuge Preauth-Key. Konfiguriere OIDC: Provider-URL, App-ID und Geheimnis, ordne E-Mail-Domains Gruppen zu.
- Optional: Setze DERP-Relay in derselben Infrastruktur auf. Trage Koordinaten in Headscale-Konfig ein, teste Erreichbarkeit aus zwei Netzen.
Erster Knoten anschließen
- Installiere Tailscale-Client auf Server oder Laptop, starte Systemdienst.
- Verbinde mit Control-Plane, gib Login-Server-Adresse und Preauth-Key an. Füge Tags oder Routenflaggen hinzu, falls nötig.
- Kontrolliere Status, Peerliste und MagicDNS-Auflösung. Pinge zwei Knoten an und teste End-to-End-Verbindung.
ACL und Routen
- Starte mit minimaler Policy: Standard Verbot, dann punktuelle Erlaubnisse für Gruppen und Tags.
- Bei Subnet-Zugriff aktiviere Routen-Ankündigung auf Zielknoten und erlaube Routen in Headscale. Prüfe Forwarding und Firewall-Regeln.
- Für Exit Nodes aktiviere systemweiten Forwarding und NAT, beschränke Exit-Rechte per Gruppen.
Typische Fehler und wie man sie vermeidet
- Keine NTP-Synchronisation: Mehr als wenige Minuten Unterschied zerstört WireGuard-Handshakes. Achte auf Zeitkorrektur.
- UDP blockiert: Firewalls oder Provider schneiden meist UDP ab, dadurch fällt Peer-Verbindung auf DERP zurück. Prüfe UDP-Freigaben und betreibe eigenen DERP nahe der Knoten.
- Falsche MTU: Führt zu Fragmentierung und TCP-Problemen. Debugge MTU über Traceroute, verringere sie ggf. um 40-80 Bytes.
- Zu weit gefasste ACL: Verfolge das Prinzip der geringsten Rechte, erteile nur konkrete Port- und Ziel-Freigaben.
- Langelebige mehrfach nutzbare Preauth-Keys: Nutze Ablaufzeiten und Einmaligkeit, besonders bei externen Nutzern.
Performance und Stabilität: Was erwartet wird und wie man misst
Geschwindigkeit: Moderne x86-Systeme mit Krypto-Beschleunigung erreichen 600–900 Mbit/s Ende-zu-Ende zwischen Rechenzentren im Direkt-Peering. Energieeffiziente SoCs (N100, N5105) liefern 300–600 Mbit/s bei korrektem MTU-Setting. Mittelklasse ARM-Geräte schaffen 100–300 Mbit/s. DERP drosselt je nach Relay-Auslastung und Standort.
Latenzen: Bei Direkt-Peering meist vergleichbar mit Internet-Routing: 2–10 ms innerhalb Region, 20–40 ms über Regionen. Über DERP kommen 10–40 ms zum Relay-Pfad hinzu. Eigener DERP im Zielgebiet senkt Zusatzlatenz um 25–60 % gegenüber entfernten Relays.
Zuverlässigkeit: Typischerweise 90–95 % Peers mit direkter Verbindung, Rest läuft über DERP. Bei symmetrischem NAT und CGNAT empfiehlt sich Relay-Planung. Monitoring von Metriken (Direkt-/DERP-Peers, Handshake-Ausfälle, Jitter) ermöglicht schnelle Reaktion.
Integration und Automatisierung: Wie man Headscale ins bestehende Ökosystem einbindet
- Reverse-Proxy: Nutze Caddy oder Traefik für automatisches TLS und einfache Routen. Headscale ans „interne“ Port mapping, außen nur Proxy.
- IaC: Halte Headscale-Konfiguration (Nutzer, ACL, Tags) in Git. Einspielen via Pipeline, Änderungen per PR-Review prüfen.
- Ansible: Rollen für tailscaled-Clients, Preauth-Key-Ausgabe, Routen-Aktivierung – praktisch für Massen-Onboarding.
- Monitoring: Sammle Headscale-Metriken in Prometheus, visualisiere sie in Grafana. Alarme bei DERP-Anteil, SSO-Fehlern, Routing-Problemen.
- Logs: Zentrale Sammlung in Elastic Stack oder Alternativen, Speicherung und Suche nach Node-Join/Leave-Events und Fehlern.
Vergleich mit Alternativen: Wo Headscale seine Stärken ausspielt und worauf zu achten ist
Headscale vs Tailscale (SaaS)
- Kontrolle und Datenspeicherung: Bei Headscale bleiben Metadaten bei dir, Compliance einfacher. Bei Tailscale liegt ein Teil der Steuerung extern.
- Flexibilität: Eigene DERP-Server, Integrationen und individuelle Konfigurationen möglich.
- Kosten: Bei wachsender Knotenzahl ist Headscale besser planbar, Infrastrukturkosten statt Nutzerlizenzen.
- Feature-Support: Grundfunktionen meist enthalten, einige Cloud-spezifische Features fehlen oder funktionieren anders. Umfang vor Migration prüfen.
Headscale vs ZeroTier
- Beide Mesh-Lösungen, Headscale basiert auf WireGuard und ist Tailscale-kompatibel, ZeroTier nutzt eigenes Protokoll.
- Headscale besitzt einfachere OS-Integration, nahtlose Linux-Konfiguration. ZeroTier passt gut für L2/L3 Hybride und virtuelle Switches.
- WireGuard bietet oft bessere CPU-Leistung durch Verschlüsselungsbeschleunigung.
Headscale vs Netmaker/Netbird
- Netmaker und Netbird sind ebenfalls WireGuard-Orchestratoren mit umfangreichem UI. Headscale punktet mit Tailscale-Client-Kompatibilität und ausgereifter ACL-/Routing-Logik, UI kann externe Panels erfordern.
- Wer schon Tailscale-Clients nutzt und Self-Hosting will, findet in Headscale meist die natürlichere Wahl.
Headscale vs klassisches VPN (OpenVPN/IKEv2)
- Mesh mit NAT-Traversal ist leichter einzurichten, widerstandsfähiger gegen restriktive Netzwerke. MagicDNS und Tags erlauben flexible Zugriffskontrolle.
- Klassische VPNs sind sinnvoll bei statischem Internet-Exit, Blockadenumgehung oder fixen Gateway-IP-Anforderungen.
Experten-Tipp zu klassischen VPN-Nutzungen
Für statische persönliche IPs, Banking aus dem Ausland, Blockadeumgehung oder feine Protokollwahl je Provider sind klassische VPNs sinnvoll. Ein praktisches Angebot ist ein persönlicher VPN-Server bei vpn.how: kein Shared Resource, dedizierte IP, diverse Protokolle (WireGuard, OpenVPN, IKEv2, L2TP, SSTP passend für Netze), globale Standorte (Moskau, Sankt Petersburg, Amsterdam, Frankfurt, London, New York, San Jose, Chicago, Singapur, Sydney, Madrid, Helsinki, Stockholm, Warschau, Kopenhagen, Stavanger), einfache Bezahlung (deutsche und russische Banken, SBP, Krypto), Tarife ab 490 ₽ pro Tag bzw. 2490 ₽/Monat mit Rabatten für Langzeit, 5-Minuten-Setup und keine Logs. Diese Lösung ergänzt Headscale ideal: Headscale für interne Mesh-Netzwerke, persönlicher VPN für privaten Internet-Exit.
FAQ: Häufige praktische Fragen
1. Kann man mobile Clients nutzen?
Auf Desktops und Servern problemlos. Mobile offizielle Clients ändern gelegentlich die Unterstützung eigener Login-Server. In Produktionen setzt man meist auf Laptops und Gateways, für Mobilgeräte lokale Proxies oder klassische VPN-Profile. Vor ausgedehntem Einsatz Kompatibilität prüfen.
2. Wie stellt man hohe Verfügbarkeit bei Headscale sicher?
Stelle Headscale hinter Reverse-Proxy mit Healthchecks, verwende ausfallsichere Datenbank, betreibe zweite Instanz in anderer AZ/Region. Halte mindestens zwei DERP-Relays. Sicherung von Konfiguration und DB ist Pflicht.
3. Wie verhält sich die Performance bei großer Knotenzahl?
Mehrere hundert Knoten sind üblich, Tausende möglich mit entsprechender Architektur und Monitoring. Beobachte Handshake-Zeiten, DERP-Anteil, DB- und TLS-Last. Rolle Control-Plane und DERP räumlich und logisch getrennt.
4. Braucht jeder Knoten eine öffentliche IP?
Nein. NAT-Traversal ermöglicht direkte Verbindungen. Öffentliche IPs braucht nur Headscale und DERP-Relays, da Außenanbindung nötig.
5. Kann man Umgebungen für mehrere „Organisationen“ aufteilen?
Ja, über Nutzer, Gruppen und Tags. Zusätzlich separate ACLs für unabhängige Teams. Für starke Isolation mehrere Headscale-Instanzen betreiben.
6. Wie migriert man von Tailscale SaaS auf Headscale?
Installiere Headscale, reproduziere ACLs und Gruppen, gib Preauth-Keys aus und konfiguriere Knoten stufenweise auf neuen Login-Server. Nutze parallele Netzwerke zur Migration. Starte mit nicht-produktiven Nodes.
7. Funktionieren Taildrop und ähnliche Funktionen?
Dateitransfer zwischen Knoten ist über privates Netz möglich, proprietäre Funktionen können vom Cloud-Verhalten abweichen. Teste mit deiner Client- und Headscale-Version.
8. Wie schützt man vor Traffic-Leaks außerhalb des Tunnels?
Nutze Exit Node mit zwingendem Default-Routing für sensible Gruppen, aktiviere DNS-Policies. Auf Clients Split-Tunnel-Verbot dort einrichten, wo nötig.
9. Was loggt Headscale? Entspricht das Datenschutz?
Es werden Steuerungsereignisse protokolliert: Authentifizierung, Node-Registrierung, Policy-Änderungen. Nutzverkehr läuft nicht über Control-Plane. Befolge interne Datensparsamkeits- und Speicherregeln.
10. Was tun, wenn der Provider UDP blockiert?
Erwarte erhöhten DERP-Anteil. Platziere eigenen DERP nahe den Knoten. Für kritische Szenarien nur auf erforderlichen Standorten TCP-Tunnel als Fallback erwägen. Prüfe Provider-Policy frühzeitig.
Fazit: Für wen Headscale ideal ist und wie der Einstieg gelingt
Wenn du Kontrolle, Compliance und planbare Kosten willst, bietet Headscale genau das. Besonders geeignet für: 1) Homelabs und KMU mit Port-Forwarding-freiem Zugriff; 2) Produktteams mit Staging und CI/CD in Multi-Cloud; 3) Hybridprojekte mit On-Prem-Datenbanken; 4) Industrie-Szenarien mit isolierten Netzen; 5) Edge-/IoT-Farmen; 6) temporäre Zugänge für externe Auftragnehmer. Stärken sind schnelles Onboarding, flexible ACLs, MagicDNS, Routen und eigene DERPs. Produktive Einführung läuft meist so: 1) Headscale hinter Reverse-Proxy aufsetzen; 2) OIDC für Onboarding aktivieren; 3) erste 3-5 Nodes registrieren; 4) Minimal-ACL mit Prinzip der geringsten Rechte definieren; 5) Metriken und Logs einschalten; 6) zwei bis drei Kernszenarien testen; 7) mit Tags und Subnet Routern skalieren. Für sicheren Internet-Exit mit eigener IP ist klassisches persönliches VPN sinnvoll – ein anderes Segment. Für interne Mesh-Netzwerke, DevOps und Hybrid-Umgebungen ist Headscale die bessere Wahl. Am Ende steht ein stabiles privates Netzwerk auf WireGuard-Basis, wo Kontrolle und Daten bei dir bleiben und neue Knoten in Minuten bereit sind. Ein seltener Fall, bei dem Sicherheit, Nutzerfreundlichkeit und Flexibilität wirklich zusammenkommen.